문제
로렌츠는 자사몰과 여러 판매 채널에서 반려동물 사료와 간식을 파는 회사예요. 직원들은 쇼핑몰 주문을 하나씩 복사해 등록하고, 배송 상태는 택배사 사이트에서 직접 확인하고, 재고 수량은 여러 곳에 따로 입력했어요.
직원은 7명이고, 대표를 빼면 AI 도구에 익숙하지 않았어요. 상담 내용은 네이버 톡톡과 업무폰 통화에 흩어져 있었고, 업무폰에는 처리되지 않은 통화 녹음이 쌓여 있었어요.
“매일 수십~수백 건의 배송을 일일이 추적하기는 어렵습니다.”
목표
- 여러 채널의 주문을 한 화면에서 처리하고 재고, 배송, 발주, 정산, 상담을 잇는다.
- AI 에이전트는 DB를 읽기만 한다. 데이터를 바꾸는 일은 기존 업무 API로, 직원이 슬랙에서 승인한 뒤에만 실행한다.
- 에이전트는 직원이 관리자 화면에서 할 수 없는 일을 대신하지 않는다. 메뉴 권한을 똑같이 검사한다.
- 일반 배포에서는 DB를 바꾸지 않고, 스키마가 맞지 않는 롤백은 막는다.
풀어 간 과정
처음 시도한 방법, 막힌 지점, 방향을 바꾼 이유를 시간 순서로 적었어요.
2025년 12월
배송 추적부터 시작했어요
첫 기능은 송장을 엑셀로 한 번에 올리고 택배사 API로 배송 상태를 조회하는 것이었어요. API가 없는 판매 채널의 주문은 Playwright 시나리오 엔진으로 가져왔어요.
2026년 1월
채널 주문을 한 화면으로
네이버 커머스 API 주문을 하나의 주문 화면으로 합치고, 수동 주문과 카페24 주문 동기화를 붙였어요. 송장을 등록하면 주문이 자동으로 배송 처리돼서, 직원이 상태를 따로 바꾸지 않아도 돼요.
2026년 6~7월
배포 사고 두 번, 배포를 트랜잭션으로
1월부터 블루그린으로 배포했지만 6월에 두 번 문제가 났어요. 배포가 이지어드민 워커를 다시 띄우지 않아 2주 전 코드가 돌았고, 새로 생긴 필수 컬럼 때문에 이지어드민 주문 동기화가 통째로 실패했어요. 같은 달에는 오래된 환경이 활성화돼 옛 코드가 나갔는데, Nginx 전환이 실패한 것도 드러나지 않았어요. 7월에 배포 기록, 워커 세대 검사, 카나리를 넣었어요.
2026년 9월
배송 조회를 송장마다 따로
6시간마다 송장 약 2,900개를 한꺼번에 조회하던 방식은 328개를 두 번 조회하고, 이지어드민 추가 송장 157개는 아예 조회하지 않았어요. 이상이 생긴 송장도 최대 6시간을 기다려야 했고요. 송장마다 다음 조회 시각을 정하고, 5분마다 때가 된 송장만 한 번에 250건까지 조회하게 바꿨어요.
2026년 3~10월
명령어 봇에서 승인받는 에이전트로
3월에 사내 API를 읽기만 하는 MCP 서버를 먼저 열었어요. 7월의 첫 슬랙 봇은 AI 모델 없이 정해진 명령 10개만 받았고, 쓰기는 막았어요. 9월에는 대표만 쓰는 읽기 전용 파일럿으로 읽기 도구를 4개에서 14개로 늘리고, 에이전트 도구 6개를 비교해 엔진을 골랐어요. 10월에 직원 7명 모두에게 열었고, 3주 동안 처리하지 못한 요청 30건 중 13건이 쓰기 요청이라 승인 후 실행하는 쓰기 작업을 붙였어요.
지금의 구조
흩어진 채널과 사람의 손을 한 흐름으로 묶었어요.
- 1
판매 채널 13곳과 수동 발주, 이지어드민 경로로 주문을 모아요. API가 없는 채널은 Playwright 시나리오 엔진이 처리해요.
- 2
Django와 Celery가 주문 동기화, 정산, 알림을 처리해요.
- 3
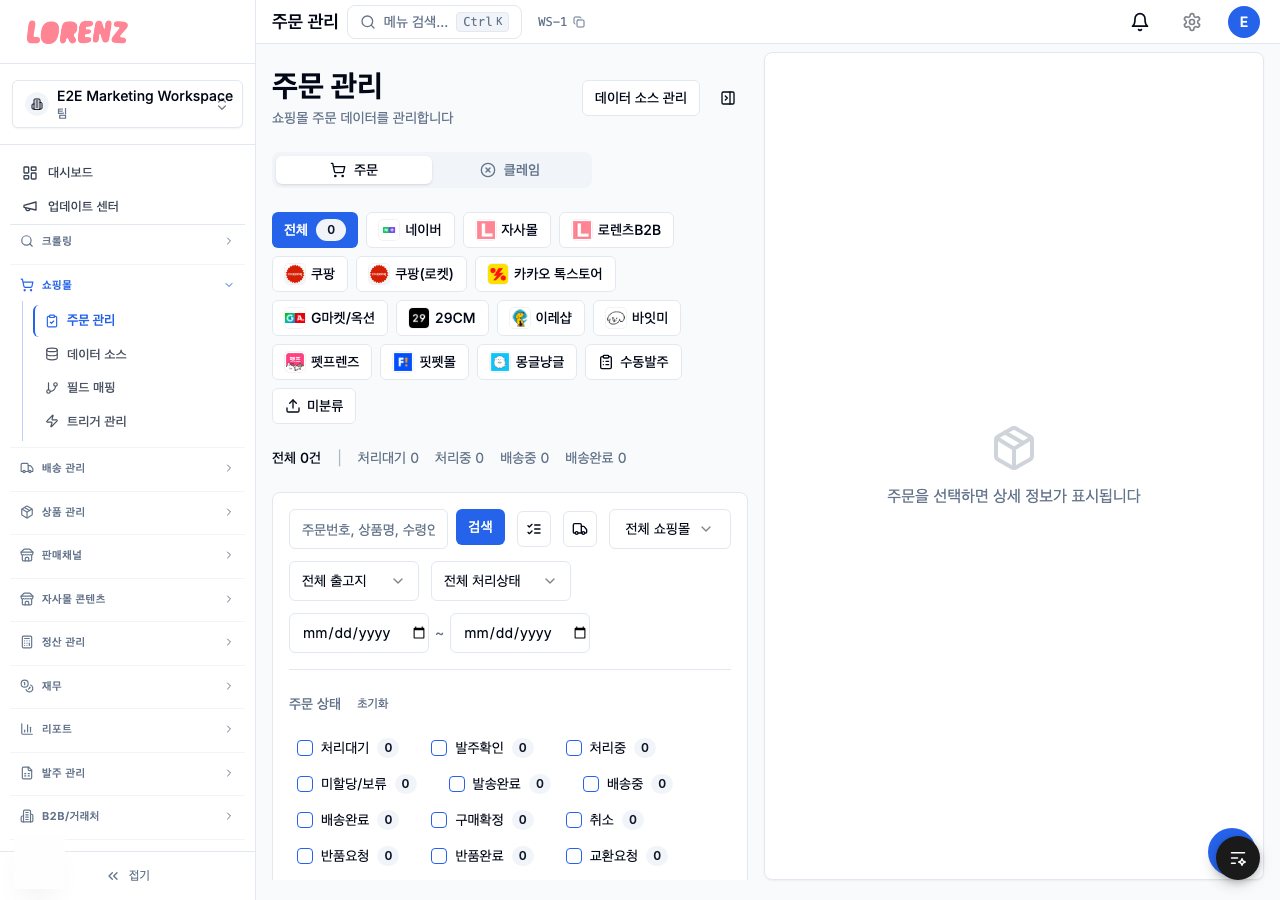
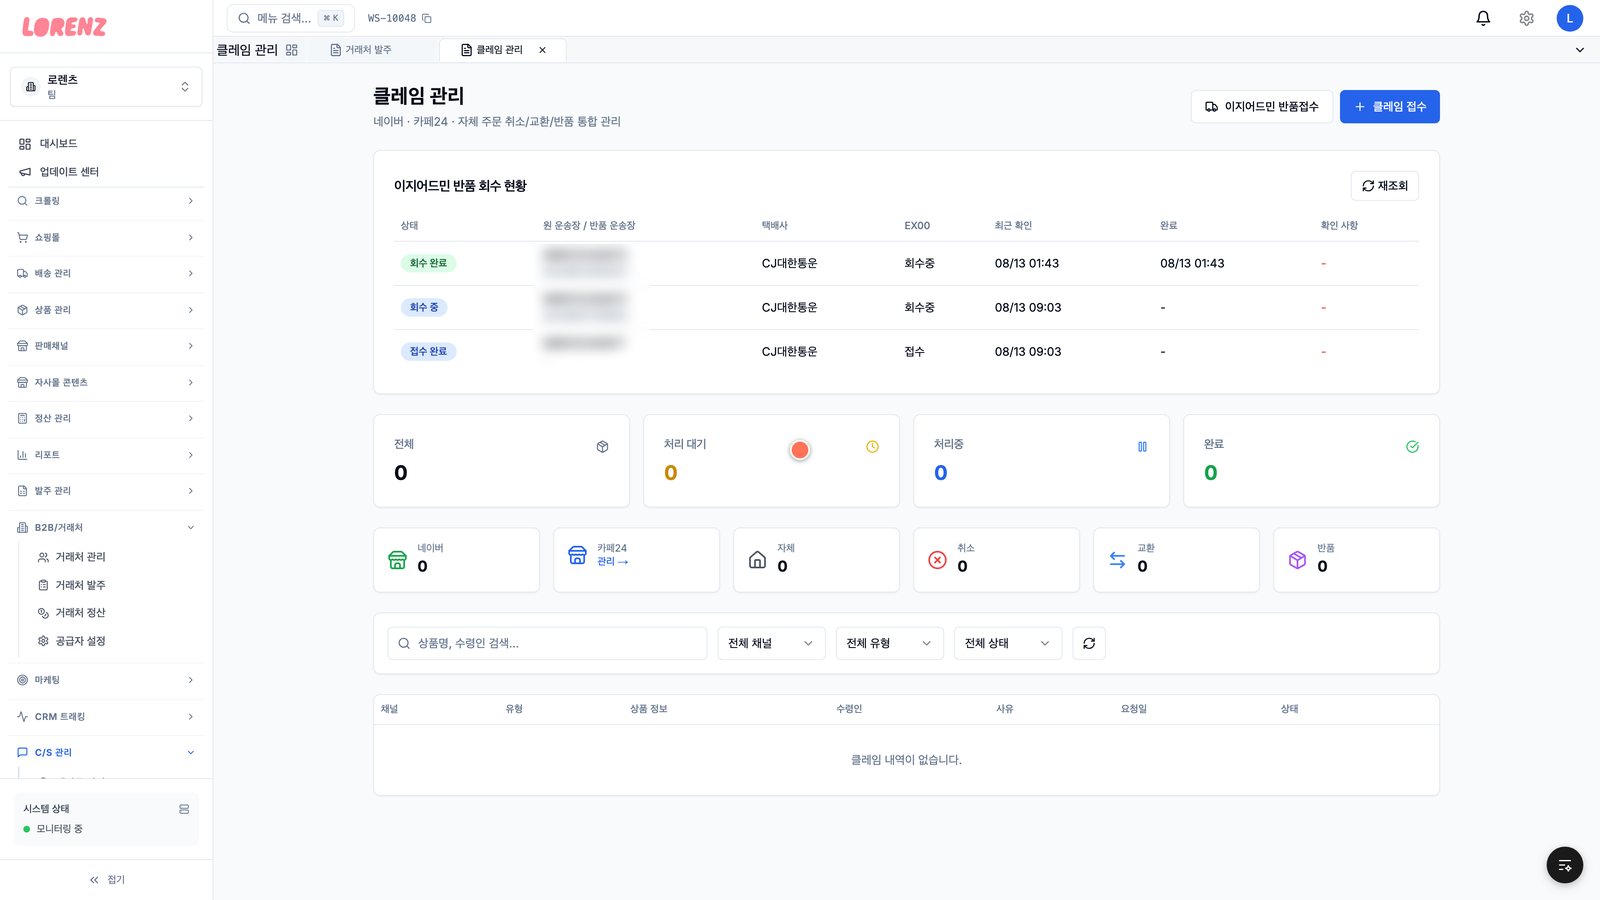
직원은 Next.js 관리자 화면의 주문 허브와 클레임, B2B 화면에서 일해요.
- 4
MCP 서버가 사내 API를 읽기 도구와 승인 도구로 열어요.
- 5
슬랙 에이전트 '로니'가 질문에 답하고, 데이터를 바꾸는 요청은 제안 카드로 올려 요청한 직원이 승인해야 실행해요.
- 6
상담 통화 녹음은 음성 인식과 요약을 거쳐 상담 기록이 되고 슬랙 채널에 올라가요. 슬랙 버튼을 누르면 크롬 확장이 해당 톡톡 채팅방과 고객 정보를 열어요.
- 7
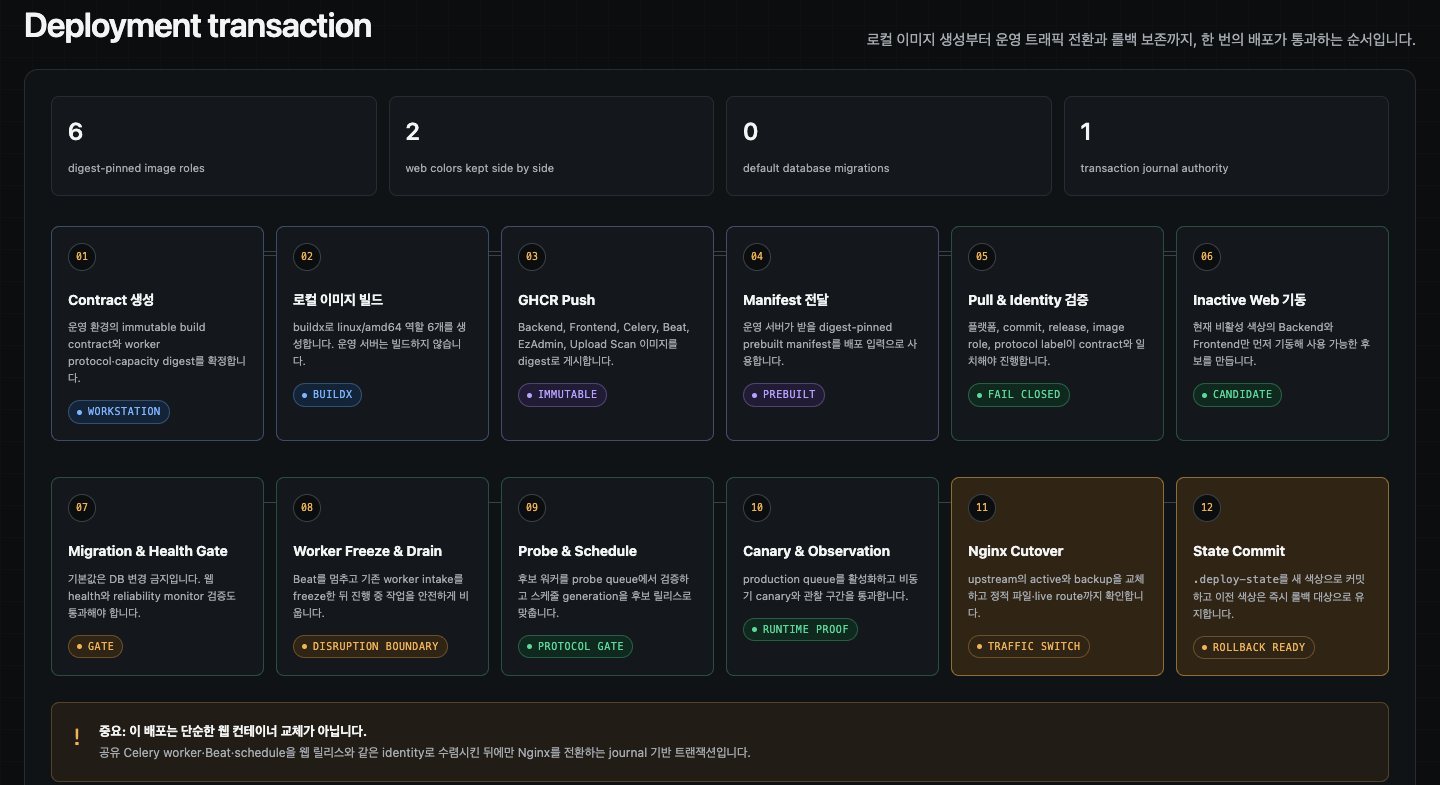
배포는 digest를 고정한 이미지로 대기 중인 쪽(블루나 그린)을 먼저 띄우고, 워커 검증과 카나리를 통과하면 Nginx 트래픽을 넘겨요.
핵심 결정
에이전트는 MCP와 승인 절차로만 데이터를 다루게
- 이유
- SQL을 직접 쓰게 하면 업무 규칙 검증을 건너뛰게 돼요. 모델의 실수나 외부 입력에 섞인 지시문이 그대로 데이터를 바꿀 수도 있고요. 그래서 기존 업무 API만 도구로 열고, 쓰기는 요청한 직원이 승인해야 실행되게 했어요.
- 다른 선택지
- 에이전트 도구 6개를 비교했고, DB에 직접 쓰게 하는 방식은 처음부터 뺐어요.
- 감수한 것
- 쓰기 작업을 종류마다 하나씩 추가해야 해요. 3주 동안 처리하지 못한 요청 30건 중 13건이 쓰기 요청이어서, 그 목록을 보고 승인 작업을 늘렸어요.
블루그린 배포에 워커 세대 검사와 카나리 더하기
- 이유
- 1월에 도입한 블루그린 배포에서도 6월에 사고가 두 번 났어요. 예전 방식은 이전 버전 웹과 워커가 아직 옛 컬럼을 읽는 동안 마이그레이션을 실행했고, 워커가 새 코드로 다시 떴는지, 롤백할 때 스키마가 맞는지도 확인하지 않았어요. 그래서 배포를 기록이 남는 트랜잭션으로 바꿨어요.
- 다른 선택지
- 기존 블루그린 배포를 그대로 쓰기
- 감수한 것
- 절차가 복잡해졌어요. 세대가 맞지 않으면 30분짜리 빌드가 끝난 뒤에야 거부되는 문제도 남아 있었어요.
톡톡 연동은 최소 권한 전용 확장으로
- 이유
- 네이버 톡톡 채팅방은 서버에서 직접 링크를 만들 수 없어요. 범용 브라우저 자동화 도구를 쓰면 직원 PC마다 로컬 서버를 띄우고 쿠키를 따로 보관해야 해서, 꼭 필요한 권한만 가진 전용 확장을 따로 만들었어요.
- 다른 선택지
- 범용 브라우저 자동화 도구, 또는 모든 사이트 권한을 가진 기존 녹화 확장에 기능 추가
- 감수한 것
- 직원 브라우저에서만 동작하고, 배포하려면 웹스토어 심사를 거쳐야 해요.
어려웠던 문제
겪었거나 배포 전에 막은 문제를 어떻게 알아챘고, 무엇을 의심해 원인을 찾았는지, 다시 일어나지 않게 무엇을 바꿨는지 기록했어요.
같은 주문이 두 번 저장되던 문제
한 판매 채널에서 같은 주문 라인이 상품주문번호만 다른 두 행으로 저장됐어요. 원인이 된 변경이 들어간 뒤 약 20일 동안이었고, 중복 행에는 운송장, 정산, 매칭 이력이 따로 붙을 수 있었어요.
왜 어려웠나
코드 주석과 커밋 메시지에 '중복은 unique 키가 막는다'고 적혀 있었어요. 그런데 그 키에 들어가는 상품주문번호를 두 수집 경로가 서로 다르게 만들고 있어서 unique 제약이 작동하지 않았고, 두 행 모두 정상 데이터처럼 보였어요.
추적 과정
1. unique 키가 막아 주지 않을까?
키를 만드는 함수는 비어 있지 않은 코드만 이어 붙여요. 화면에서 읽으면 상품 코드만 있어 '번호|상품'이 되고, 엑셀에서 읽으면 '번호|품목|판매|상품|옵션'이 됐어요.
2. 대체 경로는 이미 있는 주문을 건너뛰지 않을까?
'없는 주문' 판단을 주문번호로만 했어요. 엑셀보다 먼저 돌면 그 주문은 아직 없는 것으로 보였어요.
3. 두 경로는 어떤 순서로 돌까?
문제가 된 변경에서 대체 경로 호출이 엑셀 파싱과 저장보다 앞에 놓여 있었어요.
4. 다시 일어나게 만들 수 있을까?
주문이 배송준비중으로 옮겨진 상황을 드라이버 스텁으로 만들어 그대로 재현했어요.
원인
주문 수집 워크플로가 배송준비중 화면을 읽는 대체 경로를 엑셀 저장보다 먼저 실행했어요. 수집 단계가 결제완료 주문을 배송준비중으로 옮기기 때문에, 대체 경로에 같은 주문이 보였고 주문번호 기준 '없는 주문' 검사도 통과했어요.
- 1수집 단계가 주문을 배송준비중으로 옮기고 엑셀을 받음
- 2배송준비중 화면에 같은 주문이 보임아직 DB에 저장 전
- 3'없는 주문'으로 판단, 짧은 키로 저장
- 4파싱 뒤 전체 키로 저장 시도
- 5키가 달라 새 행 생성, 같은 라인이 두 행
해결
엑셀 저장이 먼저, 대체 경로는 그 뒤에 돌게 순서를 바꿨어요. 성공 판정은 엑셀이 실패했을 때만 대체 경로 결과에 맡겨요. 이미 생긴 중복은 정리 명령으로 지웠는데, 남길 행은 운송장이 있는 행, 엑셀 전체 키를 가진 행 순으로 고르고, 참조를 그 행으로 옮긴 뒤 지워요.
고치기 전
    self._scrape_preparing_orders_into_db(driver, result)
if file_path is None:
    return result
orders = self.parse_excel_file(file_path)
saved, new, upd = self.save_orders_to_db(orders)
고친 뒤
    if file_path is not None:
        orders = self.parse_excel_file(file_path)
        if orders:
            saved, new, upd = self.save_orders_to_db(orders)
        else:
            excel_parse_failed = True
    self._scrape_preparing_orders_into_db(driver, result)  # 엑셀 다음
result["success"] = (not excel_parse_failed) or result["scraped_new"] > 0

# 정리 명령: 세 값이 모두 같을 때만 지워요
return (loser.total_price == survivor.total_price
        and loser.quantity == survivor.quantity
and loser.product_name.strip() == survivor.product_name.strip())검증
- 배송준비중으로 옮겨진 주문을 재현한 테스트에서 행이 하나만 남고, 그 행이 엑셀 전체 키인지 확인
재발 방지
- 실행 순서가 왜 중요한지 코드 주석으로 남겼어요.
- 정리 명령은 기본이 미리보기예요. 운송장이 있거나 진행 상태가 아닌 주문은 명시적으로 허용해야만 건드려요.
남긴 원칙
unique 키가 중복을 막는다는 말은, 모든 경로가 같은 키를 만들 때만 맞아요.
되돌릴 수 없는 마이그레이션을 배포 직전에 막은 일
데이터를 복사하고 옛 컬럼을 지우는 마이그레이션이 들어간 릴리스를 준비하다가, 기존 배포 순서로는 이전 버전 웹과 워커가 아직 그 컬럼을 읽는 동안 컬럼이 지워진다는 걸 찾았어요. 일반 배포를 막고 503 점검 전환으로 바꿨고, 운영 데이터와 트래픽이 바뀌기 전에 멈췄어요.
왜 어려웠나
그 배포에 걸린 기존 테스트는 백엔드 577개, 배포 395개가 모두 통과했어요. 워커 프로토콜 검사는 메시지 형식이 맞는지만 보고, 이전 컨테이너가 남아 있으니 롤백도 안전해 보였어요. 문제는 코드가 아니라 배포 순서와 복구 경로에 있었어요.
추적 과정
1. 자동 배포에 마이그레이션을 맡겨도 될까?
배포 순서가 새 웹 시작, 마이그레이션, 워커 검증, 이전 워커 중단이었어요. 컬럼을 지우는 순간에도 이전 버전이 살아 있어요.
2. 문제가 생기면 되돌리면 되지 않을까?
복구 경로들이 스키마를 확인하지 않았어요. 여러 항목을 묶는 관계로 바뀐 데이터는 단일 외래키로 되돌릴 수 없었고, 마이그레이션을 가짜로 적용 처리하는 것도 답이 아니었어요.
3. 복사만 되고 삭제는 남은 상태는?
반쯤 적용된 상태도 막아야 해서, 그 조합을 테스트 입력으로 넣었어요.
4. 어디까지 왔는지는 어디에 기록할까?
배포 기록이 끝나거나 바뀌거나 손상돼도 남아야 해서, root만 쓸 수 있는 상태 파일로 판단하게 했어요.
원인
배포 스크립트의 마이그레이션 검사(ensure_safe_migration_plan)가 되돌릴 수 없는 마이그레이션도 온라인 배포에서 허용했고, 워커 재시작, Nginx 전환, 역방향 복구 어디에도 스키마 확인이 없었어요.
- 1새 버전 웹 시작정상 처리 중
- 2데이터 복사옛 컬럼을 계속 사용
- 3옛 컬럼 삭제지워진 컬럼 조회, 오류
- 4워커 검증, 이전 워커 중단이미 늦음
- 5실패해서 되돌리기스키마 확인 없이 이전 버전을 다시 띄움
해결
데이터 복사나 컬럼 삭제가 들어간 마이그레이션이 대기 중이면 일반 배포를 거부해요. 이런 전환은 트래픽을 멈추고, 진행 중인 작업을 비우고, 격리된 PostgreSQL에서 백업 복원을 검증한 뒤 진행해요. 전환이 끝나면 '스키마 복구 하한'을 기록해서, 롤백이든 이전 컨테이너 재기동이든 그보다 아래 코드는 띄우지 못하게 했어요.
핵심 코드
# 대기 중인 마이그레이션에 스키마 전환이 있으면 일반 배포를 멈춰요
while IFS= read -r migration; do
  case "$migration" in
    <data-copy>|<column-drop>|<create-copy-drop>)
      error "Schema transition requires a quiesced cutover and verified database recovery"
      return 1 ;;
  esac
done < <(pending_migration_names)

# 워커 시작, Nginx 전환, 역방향 복구 앞마다 하한을 확인해요
start_workers() {
  schema_release_allowed "${GIT_COMMIT:-}" || return 1
reverse_deployment_transaction() {
  schema_entry_allowed || return 1
schema_release_allowed "$JOURNAL_PREDECESSOR_COMMIT" || return 1검증
- 새 회귀 테스트 3개가 수정 전 스크립트에서 실패하는 것부터 확인
- 배포 회귀 테스트를 398, 418, 436개로 늘려 가며 통과
- 격리된 PostgreSQL 복원으로 리허설하고, 실제 게이트가 새 릴리스는 받고 옛 릴리스는 거부하는 것을 확인
재발 방지
- 스키마 전환 뒤에는 앞으로만 복구해요.
- 롤백은 대기 중인 색상과 스키마 하한을 모두 만족해야 해요.
- 호스트 Nginx에 빠져 있던 503 안내와 오류 처리도 되살렸어요.
남긴 원칙
워커 프로토콜이 맞는다고 DB 스키마까지 맞는 건 아니에요. 이전 컨테이너가 남아 있어도, 스키마 하한보다 아래 코드는 띄우지 않아요.
카나리 검사가 워커를 죽이고, 롤백까지 막힌 일
블루그린 배포가 두 번 연속 실패했어요. 트래픽은 그대로였지만 작업 워커는 새 버전, 웹은 이전 버전에 남아 버전이 어긋났고, 다음 배포는 이 불일치를 감지해 시작부터 거부됐어요.
왜 어려웠나
로그에는 준비 상태 확인 실패만 보였는데, 같은 문구가 정상 부팅 중에도 반복돼요. 재시도 설정을 늘려도 효과가 없었고, 메모리 부족 흔적은 커널 로그에만 있었어요. 되돌리는 작업도 같은 Nginx 검증을 다시 통과해야 해서 같은 자리에서 실패했어요.
추적 과정
1. 부팅이 느린 걸까?
준비 상태 재시도를 늘려도 효과가 없었어요.
2. 컨테이너는 어떤 상태일까?
재시작 횟수가 계속 올라가고 있었어요. 죽었다 살아나는 중이었어요.
3. 왜 죽을까?
커널 로그에 'Memory cgroup out of memory: Killed process (celery)'가 있었어요.
4. 무엇이 메모리를 먹었을까?
768MiB 한도에서 평소 560MiB, 약 73%를 쓰는 워커 안에, 카나리가 docker exec로 파이썬과 Django를 하나 더 띄우고 있었어요.
5. 롤백은 왜 실패했을까?
되돌리기가 Nginx 전환 단계의 같은 후보 검증에서 다시 실패해, 손으로 정리해야 하는 상태가 됐어요.
원인
업로드 검사 워커의 메모리 한도 768MiB가 상주 프로세스와 카나리 검사 프로세스를 함께 담지 못했어요. 되돌리기 역시 전환과 같은 Nginx 검증을 거치게 되어 있어서 같은 단계에서 막혔어요.
- 1워커 활성화평소 약 560MiB / 한도 768MiB
- 2beat 시작남은 여유 약 200MiB
- 3큐를 켜고 docker exec로 카나리 실행검사 프로세스가 Django를 불러옴
- 4한도 초과, 커널이 워커를 강제 종료
- 5카나리 실패로 배포 중단
- 6되돌리기가 Nginx 단계에서 실패워커는 새 버전, 웹은 이전 버전
- 7다음 배포가 불일치를 감지하고 거부
해결
업로드 검사 워커 한도를 1,536MiB로, beat는 1GiB로 올리고, 워커 시작 대기 시간을 60초에서 240초로 늘렸어요. 한도는 이미지 라벨에 함께 구워지기 때문에 배포 계약과 이미지를 새로 만들었고, 스크립트는 한도를 낮추는 설정을 거부해요.
고치기 전
WORKER_START_TIMEOUT="${WORKER_START_TIMEOUT:-60}"
validate_minimum_capacity <BEAT_LIMIT> "${..:-512m}" 512
validate_minimum_capacity <UPLOAD_SCAN_LIMIT> "${..:-768m}" 768
고친 뒤
WORKER_START_TIMEOUT="${WORKER_START_TIMEOUT:-240}"
validate_minimum_capacity <BEAT_LIMIT> "${..:-1g}" 1024
validate_minimum_capacity <UPLOAD_SCAN_LIMIT> "${..:-1536m}" 1536검증
- 기본 메모리 한도가 OOM에 안전한지 검사하는 테스트 추가, 기존 기대값을 768m에서 1,536m로 갱신
- 이후 실측에서 업로드 검사 워커 메모리 사용률 37.94%
재발 방지
- 배포 전에 워커 4종의 메모리 사용률이 70% 아래인지 확인해요.
- 복구 중에는 일반 이미지 정리를 금지하고, 배포 기록이 참조하는 이미지는 지우지 못하게 했어요.
- 웹과 워커 버전이 어긋났을 때의 5단계 복구 절차를 문서로 남겼어요.
남긴 원칙
준비 상태 재시도를 늘려서는 해결되지 않아요. 그리고 복구 중에 이미지를 정리하면, 되돌아갈 이미지가 사라질 수 있어요.
결과
- 주문 허브
- 판매 채널 13곳과 수동 발주를 한 화면에서
- 외부 연동
- 택배사, 은행 계좌 조회 포함 25곳 넘게
- 배송 조회
- 6시간마다 일괄 조회에서, 송장마다 30분~12시간 간격으로
- 운영 에이전트
- MCP 도구 30여 개, 승인으로 실행하는 작업 8종
- 에이전트 점검
- 직무별 질문 28개 중 27개 통과
- 승인 카드
- 요청 후 약 10초 안에 슬랙에 올라와요
- 테스트 파일
- 백엔드 1,264개, 프론트엔드 517개
- 직원이 쇼핑몰 주문을 복사해 등록하거나, 택배사 사이트에서 배송을 하나씩 조회하지 않아요.
- 상품 입수량이나 최소 주문 수량을 다른 직원에게 묻지 않고 슬랙에서 로니에게 물어요.
- 상담 통화가 요약된 상담 기록으로 남아 슬랙 채널에서 바로 보여요.
같이 일한 방식
- 직원들이 실제로 한 업무 질문 40개로 검증 세트를 만들었고, 직무별 질문 28개를 DM으로 보내 에이전트를 점검했어요. 27개가 통과했고, 실패한 1개는 백엔드 권한 버그여서 고쳤어요.
- 에이전트가 처리하지 못한 요청을 모아 다음에 만들 기능의 순서를 정했어요.
- 직원이 고친 답변이 사내 위키보다 우선하도록 규칙을 정했어요.
- 비개발 직원을 위한 해요체 설치 가이드와 사용자 가이드 문서를 쓰고, 관리자 화면 안에 공지와 기능 요청, 버그 게시판을 두었어요.